
Grok 4.7 im Ausblick: Veröffentlichung, mögliche Verbesserungen und offene Fragen
Wann könnte Grok 4.7 erscheinen, und was könnte sich verbessern? Ein Überblick über Hinweise zum Start, bestätigte Informationen sowie Schlussfolgern, Effizienz und Agentenaufgaben.
Wann erscheint Grok 4.7, und wie groß könnten die Fortschritte sein? Die bisherigen Hinweise zum Veröffentlichungstermin und die Erwartungen an seine Fähigkeiten erlauben noch keine eindeutige Antwort. Zunächst lohnt sich ein Blick auf die Belege hinter diesen Erwartungen und auf die praktischen Aufgaben, bei denen sich eine neue Version bewähren müsste.
Stand 8. September 2026 führen die für diesen Artikel geprüften offiziellen Entwicklerdokumente Grok 4.6 weiterhin als neuestes Modell. Die Versionshinweise dokumentieren dessen Start über die xAI API am 12. August. Bei dieser Prüfung haben wir keinen offiziellen Veröffentlichungseintrag für Grok 4.7 gefunden. Das beschreibt die Grenzen unserer Überprüfung und bedeutet nicht, dass es über andere Kanäle keine Neuigkeiten gegeben hat. Siehe die offiziellen Grok-Versionshinweise.
Dieser Artikel ist ein Ausblick. Geschätzte Termine und Analysen möglicher Fähigkeiten von Grok 4.7 sind keine offiziellen Zusagen. Maßgeblich für Veröffentlichung, Zugangsberechtigung und technische Daten sind die offiziellen Ankündigungen.
Veröffentlichung: Woher stammt die Schätzung für Mitte September?
Die Schätzung für Mitte September geht auf eine Meldung zurück, deren ursprüngliche Quelle noch geprüft werden muss. Im Ausgangsentwurf wurde Elon Musk eine Aussage vom 2. September zugeschrieben, wonach Grok 4.7 in ungefähr zehn Tagen erscheinen solle.
Wenn diese Wiedergabe stimmt und der Zeitplan unverändert bleibt, ergibt sich aus zehn Tagen nach dem 2. September ein Termin um den 12. September. Zum Aktualisierungszeitpunkt dieses Artikels haben wir jedoch weder den ursprünglichen Beitrag noch seinen vollständigen Kontext verifiziert. Daher können wir dieses Datum nicht als bestätigten Veröffentlichungstag nennen.
Selbst wenn die ursprüngliche Ankündigung gefunden wird, müsste ihre Bedeutung geklärt werden: Geht es um die Veröffentlichung des Modells, den Beginn von Tests oder den Zugang für ausgewählte Nutzer? Eine Produktankündigung, die Verfügbarkeit im Web und der API-Zugang sind unterschiedliche Meilensteine. Ein geschätztes Datum belegt nicht, dass alle drei gleichzeitig eintreten.
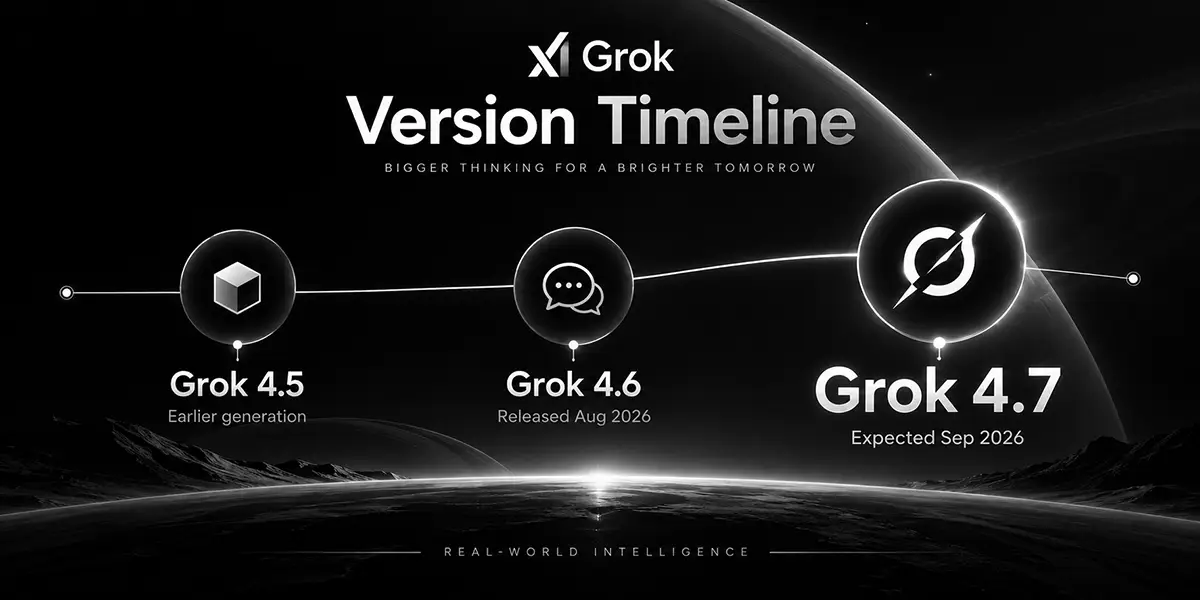
Die für Grok 4.7 dargestellte Erwartung für September 2026 veranschaulicht eine unbestätigte Terminschätzung. Die Grafik ist weder eine offizielle Roadmap noch ein Beleg für ein Veröffentlichungsdatum.
Was ist bekannt, und was muss noch bestätigt werden?
Ein überprüfbarer Ausgangspunkt ist vorhanden: Die offizielle Dokumentation beschreibt Grok 4.6 als Modell für Programmierung, Agentenaufgaben und Wissensarbeit. Es unterstützt Text- und Bildeingaben, Textausgaben, Funktionsaufrufe, strukturierte Ausgaben und Schlussfolgern. Diese Angaben bilden eine Grundlage für die Bewertung einer Folgeversion. Siehe die offizielle Modelldokumentation zu Grok 4.6.
Für Grok 4.7 liegen diesem Artikel noch nicht genügend verifizierte Informationen vor, um Folgendes zu bestätigen:
- Einführung: Der offizielle Starttermin, die ersten unterstützten Plattformen und eine mögliche schrittweise Freigabe.
- Zugang und Preise: Berechtigte Abonnements, API-Verfügbarkeit, Nutzungslimits und Preise.
- Technische Änderungen: Kontextlänge, Ein- und Ausgabetypen sowie Änderungen bei der Werkzeugnutzung.
- Leistung: Reproduzierbare Benchmark-Ergebnisse, Testkonfigurationen und das Ausmaß möglicher Verbesserungen bei realen Aufgaben.
Diese Lücken begrenzen auch die Aussagekraft von Vergleichen. Eine neue Versionsnummer belegt für sich genommen weder höhere Genauigkeit noch mehr Geschwindigkeit oder geringere Kosten. Ebenso bedeutet eine vorhandene Produktfunktion nicht, dass ein neues Modell sie über jede Oberfläche unterstützen wird.
Drei Schwerpunkte: Was muss ein neues Modell zeigen?
Die folgenden Bereiche sind Vorschläge für die Bewertung, keine Liste bestätigter Funktionen von Grok 4.7. Sie betreffen Verbesserungen, die Nutzer bei Recherche, Programmierung und Automatisierung unmittelbar bemerken könnten.
1. Verlässliches Schlussfolgern: Halten die Ergebnisse einer Prüfung stand?
Komplexe Aufgaben verlangen häufig, dass ein Modell mehrere Quellen, konkurrierende Anforderungen und widersprüchliche Informationen verarbeitet. Eine vollständig wirkende Antwort muss nicht auf belastbaren Schlussfolgerungen beruhen. Ein relevanter Fortschritt würde sich durch weniger ausgelassene Fakten, passende Belege und einen klaren Hinweis bei unzureichender Informationslage zeigen.
Soll ein Modell beispielsweise die Veröffentlichungsgeschichte eines Produkts zusammenstellen, prüfen Sie, ob es Vorankündigungen von tatsächlichen Starts unterscheidet, Verfügbarkeitstermine verschiedener Regionen oder Plattformen verwechselt und jedes wichtige Datum mit einer nachvollziehbaren Quelle belegt.
Bei Programmieraufgaben gelten ähnliche Maßstäbe: Behebt die vorgeschlagene Änderung das ursprüngliche Problem, besteht sie vorhandene Tests und vermeidet sie neue Fehler? Diese Ergebnisse sind aussagekräftiger als Länge oder Tonfall einer Antwort.
2. Effizienz: Wie viel Zeit und Geld kostet dieselbe Aufgabe?
Effizienz lässt sich am besten über den gesamten Ablauf messen, von der ersten Anfrage bis zu einem brauchbaren Ergebnis. Eine schnelle erste Antwort kann trotzdem zu einer längeren Gesamtbearbeitung führen, wenn wiederholte Rückfragen, Korrekturen oder erneute Durchläufe nötig sind.
Falls Grok 4.7 über eine API verfügbar wird, wären unter vergleichbaren Bedingungen folgende Messwerte hilfreich:
- Die gesamte Bearbeitungszeit und die Wartezeit bis zum Beginn der Antwort.
- Der gesamte Token-Verbrauch sowie die Anzahl der Werkzeugaufrufe und Wiederholungsversuche.
- Die Kosten je erfolgreich abgeschlossener Aufgabe nach den geltenden Abrechnungsregeln.
Eine kürzere Antwort ist nicht zwangsläufig effizienter. Fehlen notwendige Belege, kosten Überprüfung und Nacharbeit weiterhin Zeit. Im Idealfall bleibt die Ergebnisqualität erhalten, während Wartezeiten und wiederholte Arbeit abnehmen.
3. Agentenaufgaben: Gelingt eine verlässliche Ausführung bis zum Ergebnis?
In einem Agentenablauf muss das Modell Werkzeuge auswählen, deren Ergebnisse auswerten und mit neuen Informationen über die nächsten Schritte entscheiden. Ein Fehler kann an jeder Stelle das Endergebnis beeinflussen. Zuverlässige Werkzeugnutzung und der Umgang mit Fehlschlägen sind deshalb wichtige Bewertungskriterien.
Bei einer Aufgabe wie der Quellenrecherche für einen Vergleichsbericht sollten Sie prüfen, ob das Modell:
- Geeignete Quellen auswählt und überprüfbare Belege beibehält.
- Such-, Dateilese- und Analysewerkzeugen die richtigen Argumente übergibt.
- Nach einem ungültigen Link oder Werkzeugfehler die Vorgehensweise anpasst, statt denselben Fehler zu wiederholen.
- Die ursprünglichen Anforderungen während einer langen Aufgabe weiter einhält.
- Klar angibt, was abgeschlossen ist und wo noch menschliche Aufmerksamkeit benötigt wird.
Die Zahl menschlicher Eingriffe ist ein nützlicher Messwert. Müssen Nutzer häufig das Ziel wiederholen, Werkzeugargumente korrigieren oder Lücken schließen, spart die Automatisierung weniger Zeit. Modell, Werkzeugberechtigungen und Ausführungsumgebung beeinflussen das Ergebnis gemeinsam. Erfassen Sie diese Faktoren getrennt, damit Unterschiede in der Produktumgebung nicht pauschal der Modellleistung zugeschrieben werden.
Was sollte mit Grok 4.6 verglichen werden?
Vorerst ist es sinnvoll, eine Vergleichsbasis festzulegen und Ergebnisse zu ergänzen, sobald offizielle Unterlagen und Zugang zu Grok 4.7 vorliegen. Die folgende Tabelle vergleicht den für diesen Artikel überprüfbaren Informationsstand; sie ist keine Leistungsrangliste.
| Vergleichspunkt | Grok 4.6 | Grok 4.7 |
|---|---|---|
| Veröffentlichungsbeleg | Offiziell dokumentierter API-Start am 12. August 2026 | Bei dieser Prüfung kein offizieller Veröffentlichungseintrag gefunden |
| Dokumentierte Fähigkeiten | Offizielle Modelldokumentation verfügbar | Hier noch nicht genügend verifizierte Informationen zu Verbesserungen |
| Termin | Veröffentlichung dokumentiert | 12. September als bedingte Schätzung aus einer unbestätigten Meldung |
| Leistungsvergleich | Kann bei bestehenden Aufgaben als Ausgangswert dienen | Nach Verfügbarkeit unter gleichen Bedingungen testen |
Das Veröffentlichungsdatum von Grok 4.6 stammt aus den offiziellen Versionshinweisen; die dokumentierten Fähigkeiten stehen auf der offiziellen Modellseite.
Wenn Sie Grok 4.6 bereits nutzen, speichern Sie Eingaben, Ausgaben und Bearbeitungszeiten einiger typischer Aufgaben. So haben Sie beim Erscheinen einer neuen Version einen konkreten Bezugspunkt und müssen sich nicht auf vage Erinnerungen an die ältere Version verlassen.
Notieren Sie außerdem Oberfläche, Einstellungen zum Schlussfolgern, Werkzeugberechtigungen und Testdatum. Webchat und API sowie aktivierte und deaktivierte Suche können unterschiedliche Ergebnisse liefern. Dokumentierte Bedingungen erleichtern die Einordnung dieser Unterschiede.
Verbesserungen nach der Veröffentlichung an realen Aufgaben testen
Benchmarks zeigen, wie ein Modell mit bestimmten Fragetypen umgeht. Seinen Nutzen für Ihre Arbeit müssen Sie dennoch anhand praktischer Aufgaben prüfen. Bereiten Sie eine kleine Auswahl mit klaren Abnahmekriterien vor, etwa Faktenprüfung, Fehlerbehebung im Code und Dokumentenanalyse.
Ein nachvollziehbarer Testablauf könnte so aussehen:
- Aufgabe und Quellenmaterial konstant halten. Geben Sie beiden Modellen dieselbe Frage, dieselben Dateien und dieselben Ausgabeanforderungen. Falls Websuche nötig ist, dokumentieren Sie Quellen und Zugriffszeiten.
- Erfolg vorab definieren. Legen Sie fest, welche Fragen ein Bericht beantworten, welche Belege er enthalten oder welche Tests der Code bestehen muss.
- Den gesamten Ablauf erfassen. Protokollieren Sie Gesamtzeit, Wiederholungsversuche, Werkzeugaufrufe und Klarstellungen oder Korrekturen durch Nutzer. Bei API-Tests gehören Token-Verbrauch und Kosten dazu.
- Ergebnisse gegen jede Anforderung prüfen. Kontrollieren Sie, ob Belege die Schlussfolgerungen stützen, wichtige Informationen enthalten sind, Code läuft und Dokumentenanalysen oder Berechnungen stimmen.
- Tests wiederholen und Ergebnisse vergleichen. Beurteilen Sie die Beständigkeit über mehrere Durchläufe, statt aus einer besonders guten oder schlechten Antwort ein Urteil abzuleiten.
Die Ergebnisse sollten konkrete Fragen beantworten: Ist die Genauigkeit gestiegen? Fehlt weniger? Ist weniger manuelle Nacharbeit nötig? Liefert das Modell dieselbe Qualität schneller oder günstiger? Für die Entscheidung über einen Wechsel sind diese Antworten hilfreicher als die pauschale Behauptung, ein Modell sei intelligenter.
Ausblick
Interessant wird Grok 4.7, wenn mögliche Fortschritte zu verlässlicherer Recherche, stabilerer Werkzeugnutzung und Ergebnissen mit weniger Nacharbeit führen. Der konkrete Veröffentlichungstermin und der Umfang der Verbesserungen benötigen weiterhin belastbarere Informationen.
Bis offizielle Details vorliegen, können Sie die Leistung Ihres aktuellen Modells dokumentieren und eigene Testaufgaben vorbereiten. Sobald die neue Version verfügbar ist, lässt sich anhand von Genauigkeit, Vollständigkeit, Zeit und Kosten entscheiden, ob sich ihr Einsatz lohnt.