
Avance de Grok 4.7: fechas, posibles mejoras y aspectos que conviene observar
¿Cuándo podría llegar Grok 4.7 y qué podría mejorar? Repasamos las pistas sobre su lanzamiento, la información confirmada y las claves de razonamiento, eficiencia y tareas con agentes.
¿Cuándo llegará Grok 4.7 y cuánto podría mejorar? Por ahora, las pistas sobre su lanzamiento y las expectativas sobre sus capacidades no permiten dar una respuesta definitiva. Un punto de partida útil es examinar las pruebas que respaldan esas expectativas y las tareas prácticas en las que una nueva versión tendría que demostrar su valor.
A fecha del 8 de septiembre de 2026, la documentación oficial para desarrolladores consultada para este artículo sigue identificando Grok 4.6 como el modelo más reciente. Las notas de versión registran su lanzamiento en la API de xAI el 12 de agosto. Durante esta revisión no encontramos una entrada formal de lanzamiento de Grok 4.7. Esto describe los límites de lo que pudimos verificar, no significa que no haya novedades en otros canales. Consulta las notas de versión oficiales de Grok.
Este artículo es un avance. Las fechas estimadas y el análisis de las posibles capacidades de Grok 4.7 no son compromisos oficiales. Consulta los anuncios formales para conocer las fechas, los requisitos de acceso y las especificaciones técnicas.
Fecha de lanzamiento: ¿de dónde sale la estimación de mediados de septiembre?
La estimación de mediados de septiembre procede de una información cuya fuente original sigue pendiente de verificación. El borrador de origen atribuía a Elon Musk una declaración del 2 de septiembre según la cual Grok 4.7 llegaría en unos diez días.
Si ese relato es correcto y el calendario no cambia, diez días después del 2 de septiembre situarían la fecha alrededor del 12 de septiembre. Sin embargo, en el momento de actualizar este artículo no hemos verificado la publicación original ni su contexto completo, por lo que no podemos presentar esa fecha como un día de lanzamiento confirmado.
Aunque se localizara el anuncio original, habría que aclarar qué significa: ¿se refiere al lanzamiento del modelo, al inicio de las pruebas o al acceso de determinados usuarios? Un anuncio de producto, la disponibilidad en la web y el acceso mediante API son hitos distintos. Una fecha estimada no demuestra que los tres vayan a coincidir.
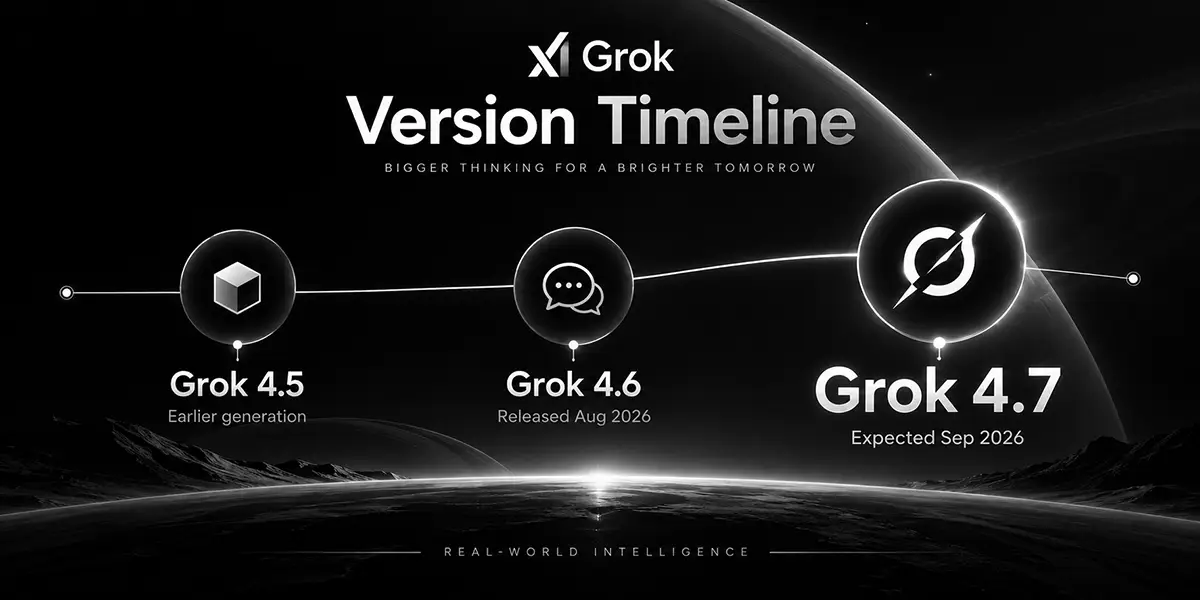
La previsión de septiembre de 2026 que aparece para Grok 4.7 representa una estimación sin verificar. No es una hoja de ruta oficial ni una prueba de la fecha de lanzamiento.
¿Qué se sabe y qué falta por confirmar?
Existe un punto de partida verificable: Grok 4.6 cuenta con documentación oficial que lo describe como un modelo para programación, tareas con agentes y trabajo del conocimiento. Admite entradas de texto e imágenes, salidas de texto, llamadas a funciones, salidas estructuradas y razonamiento. Estos datos sirven como referencia para evaluar una versión posterior. Consulta la documentación oficial del modelo Grok 4.6.
En el caso de Grok 4.7, este artículo todavía no dispone de suficiente información verificada para confirmar lo siguiente:
- Despliegue: Fecha oficial de lanzamiento, primeras plataformas y posible apertura gradual del acceso.
- Acceso y precios: Suscripciones compatibles, disponibilidad de la API, límites de uso y precios.
- Cambios técnicos: Longitud de contexto, tipos de entrada y salida, y cambios en el uso de herramientas.
- Rendimiento: Resultados reproducibles de pruebas comparativas, configuraciones de evaluación y magnitud de las mejoras en tareas reales.
Estas lagunas también limitan las conclusiones de cualquier comparación. Un nuevo número de versión no demuestra por sí solo mayor precisión, velocidad o ahorro. Del mismo modo, que una función exista en un producto no confirma que el nuevo modelo vaya a ofrecerla desde todas sus interfaces.
Tres áreas clave: ¿qué tendría que demostrar un nuevo modelo?
Los siguientes apartados son prioridades de evaluación propuestas, no una lista de funciones confirmadas de Grok 4.7. Se centran en mejoras que los usuarios podrían percibir directamente al investigar, programar o automatizar tareas.
1. Fiabilidad del razonamiento: ¿resisten las conclusiones una revisión?
Las tareas complejas suelen exigir que un modelo trabaje con varias fuentes, requisitos contrapuestos e información contradictoria. Una respuesta que parece completa no necesariamente refleja un razonamiento sólido. Un avance significativo implicaría menos hechos omitidos, citas que respalden las conclusiones y un reconocimiento claro cuando la información disponible no sea suficiente.
Por ejemplo, si pides al modelo una cronología de lanzamientos de un producto, comprueba si distingue los anuncios previos de los lanzamientos reales, si confunde fechas de disponibilidad entre regiones o plataformas y si ofrece una fuente rastreable para cada fecha importante.
Las tareas de programación tienen criterios similares: ¿la solución propuesta resuelve el problema original, supera las pruebas existentes y evita introducir regresiones? Estos resultados aportan mejores indicios de una mejora del razonamiento que la longitud o el tono de la respuesta.
2. Eficiencia: ¿cuánto tiempo y dinero requiere la misma tarea?
La eficiencia se mide mejor a lo largo de todo el proceso, desde la petición inicial hasta un resultado utilizable. Una primera respuesta rápida puede acabar alargando la tarea si exige aclaraciones, correcciones o ejecuciones repetidas.
Si Grok 4.7 llega a estar disponible mediante una API, sería útil medir, en condiciones comparables:
- El tiempo total de ejecución y la espera hasta que empieza la respuesta.
- El consumo total de tokens, las llamadas a herramientas y los reintentos.
- El costo por tarea completada correctamente, según las reglas de facturación aplicables.
Una respuesta más corta no implica necesariamente mayor eficiencia. Si omite pruebas necesarias, verificar y rehacer el resultado también lleva tiempo. La mejora ideal conservaría la calidad del resultado y reduciría las esperas y el trabajo repetido.
3. Tareas con agentes: ¿puede ejecutar el trabajo de forma fiable y entregar un resultado?
En un flujo con agentes, el modelo debe elegir herramientas, leer sus resultados y decidir qué hacer a continuación conforme recibe nueva información. Un error en cualquier paso puede afectar la entrega final, por lo que la fiabilidad de las herramientas y la recuperación ante fallos son aspectos importantes de la evaluación.
En una tarea como reunir fuentes y elaborar un informe comparativo, comprueba si el modelo:
- Elige fuentes adecuadas y conserva citas verificables.
- Pasa los argumentos correctos a las herramientas de búsqueda, lectura de archivos y análisis.
- Cambia de enfoque tras un enlace roto o un error de herramienta, en lugar de repetir el fallo.
- Mantiene los requisitos originales durante una tarea larga.
- Identifica claramente qué está terminado y qué sigue necesitando atención humana.
El número de intervenciones humanas es una medida útil. Si el usuario debe recordar continuamente el objetivo, corregir argumentos o completar omisiones, la automatización ahorra menos tiempo. El modelo, los permisos de las herramientas y el entorno de ejecución influyen en el resultado: regístralos por separado para no atribuir todas las diferencias del entorno a la capacidad del modelo.
¿Qué conviene comparar con Grok 4.6?
Por ahora, lo útil es establecer una referencia y añadir resultados cuando haya documentación oficial y acceso a Grok 4.7. La tabla compara la información verificable para este artículo; no es una clasificación de rendimiento.
| Aspecto | Grok 4.6 | Grok 4.7 |
|---|---|---|
| Prueba del lanzamiento | Registro oficial: API disponible desde el 12 de agosto de 2026 | No se encontró una entrada formal de lanzamiento en esta revisión |
| Documentación de capacidades | Documentación oficial disponible | Información verificada insuficiente para confirmar mejoras |
| Fechas | Lanzamiento documentado | El 12 de septiembre es una estimación condicional basada en un informe no verificado |
| Comparación de rendimiento | Puede servir de referencia en tareas existentes | Probar en las mismas condiciones cuando esté disponible |
La fecha de lanzamiento de Grok 4.6 procede de las notas de versión oficiales; sus capacidades documentadas se describen en la página oficial del modelo.
Si ya utilizas Grok 4.6, guarda las entradas, salidas y tiempos de ejecución de algunas tareas habituales. Así tendrás una referencia concreta cuando llegue una nueva versión, en lugar de depender de recuerdos imprecisos sobre el rendimiento anterior.
Registra también la interfaz, la configuración de razonamiento, los permisos de las herramientas y la fecha de prueba. El chat web y la API, o la búsqueda activada y desactivada, pueden producir resultados distintos. Documentar esas condiciones facilita interpretar las diferencias.
Cómo comprobar las mejoras con tareas reales después del lanzamiento
Las pruebas comparativas ayudan a entender el rendimiento de un modelo en determinados tipos de preguntas, pero su valor para tu trabajo debe comprobarse con tareas prácticas. Prepara un pequeño conjunto con criterios de aceptación claros, como verificar datos, corregir código y analizar documentos.
Un proceso que pueda revisarse después podría ser el siguiente:
- Mantén constantes la tarea y los materiales. Da a ambos modelos la misma pregunta, archivos y requisitos de salida. Si necesitan buscar en la web, registra las fuentes y las horas de acceso.
- Define el éxito antes de probar. Especifica qué preguntas debe resolver el informe, qué pruebas necesitan sus conclusiones o qué tests debe superar el código.
- Registra toda la ejecución. Anota el tiempo total, los reintentos, las llamadas a herramientas y las aclaraciones o correcciones del usuario. En pruebas de API, registra también tokens y costos.
- Revisa cada requisito. Verifica que las citas respalden las conclusiones, que no falte información importante, que el código funcione y que el análisis de documentos o los cálculos sean correctos.
- Repite las pruebas y compara los resultados. Usa varias ejecuciones para evaluar la consistencia, en lugar de sacar conclusiones de una respuesta excepcionalmente buena o mala.
Los resultados deberían responder preguntas concretas: ¿mejoró la precisión? ¿Hay menos omisiones? ¿Se necesita menos corrección manual? ¿Se obtiene la misma calidad más rápido o a menor costo? Estas respuestas ayudan más a decidir si cambiar de modelo que la afirmación general de que uno es más inteligente.
Reflexiones finales
El interés de Grok 4.7 reside en si sus posibles avances se traducen en investigaciones más fiables, un uso más estable de herramientas y entregas que requieren menos trabajo adicional. Tanto su fecha concreta de lanzamiento como el alcance de las mejoras siguen necesitando más información verificable.
Mientras llegan los detalles oficiales, registra el rendimiento de tu modelo actual y prepara tus propias tareas de prueba. Cuando la nueva versión esté disponible, valora si merece la pena adoptarla en función de la precisión, la integridad del resultado, el tiempo y el costo.