
Grok 4.7 en perspective : calendrier, améliorations possibles et points à surveiller
Quand Grok 4.7 pourrait-il arriver et que pourrait-il améliorer ? Le point sur les indices de lancement, les faits confirmés, le raisonnement, l'efficacité et les tâches confiées aux agents.
Quand Grok 4.7 arrivera-t-il, et quelle progression peut-on en attendre ? Pour l'instant, les indices concernant sa sortie et les attentes autour de ses capacités ne permettent pas de répondre avec certitude. Il est utile de commencer par examiner les éléments qui fondent ces attentes et les tâches concrètes sur lesquelles une nouvelle version devrait faire ses preuves.
Au 8 septembre 2026, la documentation officielle destinée aux développeurs consultée pour cet article présente toujours Grok 4.6 comme le modèle le plus récent. Les notes de version indiquent sa mise à disposition sur l'API xAI le 12 août. Nous n'avons pas trouvé d'entrée officielle annonçant la sortie de Grok 4.7 lors de cette vérification. Cela précise les limites de nos recherches, sans signifier qu'aucune information n'a circulé sur d'autres canaux. Voir les notes de version officielles de Grok.
Cet article propose un aperçu avant lancement. Les dates estimées et l'analyse des capacités potentielles de Grok 4.7 ne constituent pas des engagements officiels. Les annonces formelles font référence pour le calendrier, les conditions d'accès et les caractéristiques techniques.
Calendrier : d'où vient l'estimation de la mi-septembre ?
L'estimation de la mi-septembre provient d'une information dont la source initiale reste à vérifier. Le brouillon d'origine attribuait à Elon Musk une déclaration du 2 septembre selon laquelle Grok 4.7 arriverait environ dix jours plus tard.
Si cette restitution est exacte et que le calendrier ne change pas, dix jours après le 2 septembre correspondent à une date autour du 12 septembre. Toutefois, au moment de la mise à jour de cet article, nous n'avons vérifié ni le post original ni son contexte complet. Nous ne pouvons donc pas présenter cette date comme un jour de sortie confirmé.
Même si l'annonce d'origine est retrouvée, il faudra en préciser le sens : s'agit-il du lancement du modèle, du début des tests ou de l'accès réservé à certains utilisateurs ? Une annonce produit, la disponibilité sur le Web et l'accès à l'API sont des étapes distinctes. Une seule date estimée ne prouve pas qu'elles auront lieu simultanément.
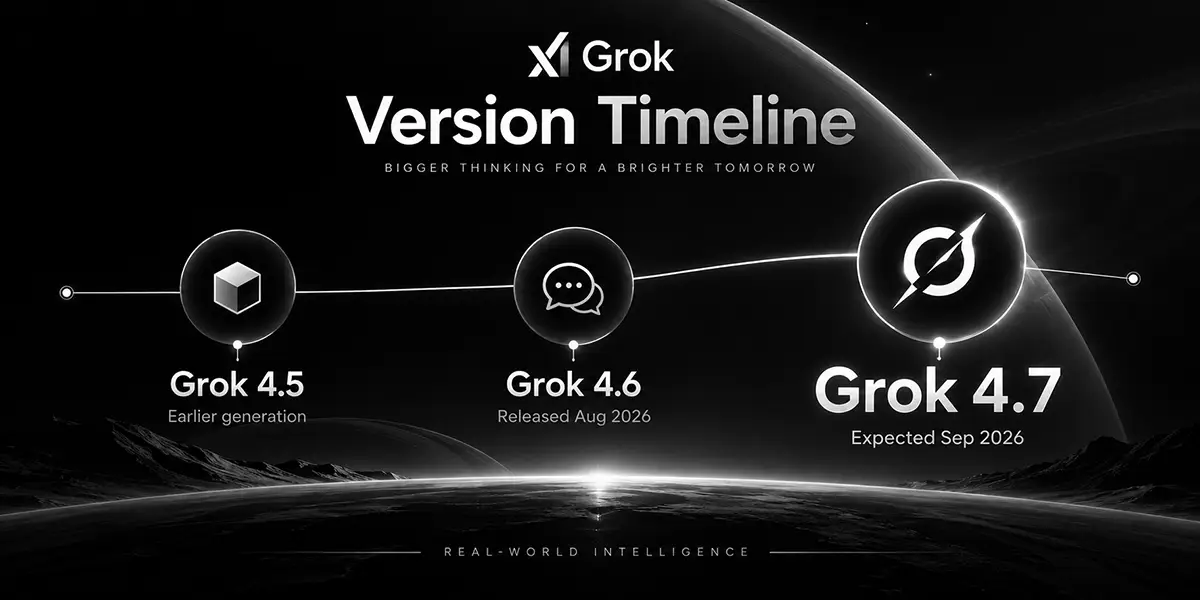
L'indication « septembre 2026 » pour Grok 4.7 illustre une estimation non vérifiée. Ce visuel n'est ni une feuille de route officielle ni une preuve de la date de sortie.
Que sait-on, et que reste-t-il à confirmer ?
Un point de départ est vérifiable : Grok 4.6 dispose d'une documentation officielle qui le présente comme un modèle pour la programmation, les tâches d'agents et le travail intellectuel. Il accepte du texte et des images en entrée, produit du texte et prend en charge les appels de fonctions, les sorties structurées et le raisonnement. Ces éléments fournissent une base pour évaluer une version ultérieure. Voir la documentation officielle du modèle Grok 4.6.
Pour Grok 4.7, cet article ne dispose pas encore d'assez d'informations vérifiées pour confirmer les points suivants :
- Déploiement : Date officielle de lancement, premières plateformes et éventuelle ouverture progressive.
- Accès et tarifs : Abonnements éligibles, disponibilité de l'API, limites d'utilisation et prix.
- Évolutions techniques : Taille du contexte, types d'entrées et de sorties, changements dans l'utilisation des outils.
- Performances : Résultats de benchmarks reproductibles, configurations de test et ampleur des progrès sur des tâches réelles.
Ces lacunes limitent également les conclusions des comparaisons. Un nouveau numéro de version ne démontre pas à lui seul davantage de précision, de rapidité ou d'économies. De même, l'existence d'une fonction dans un produit ne prouve pas que le nouveau modèle la prendra en charge dans toutes ses interfaces.
Trois axes d'évaluation : que doit démontrer un nouveau modèle ?
Les domaines suivants sont des priorités d'évaluation proposées, pas une liste de fonctions confirmées de Grok 4.7. Ils concernent des améliorations directement perceptibles dans la recherche, la programmation et l'automatisation.
1. Fiabilité du raisonnement : les conclusions résistent-elles à la vérification ?
Les tâches complexes obligent souvent un modèle à traiter plusieurs sources, des contraintes concurrentes et des informations contradictoires. Une réponse apparemment complète ne repose pas nécessairement sur un raisonnement solide. Un progrès significatif se traduirait par moins de faits omis, des références qui étayent les conclusions et une reconnaissance claire des informations insuffisantes.
Par exemple, pour établir la chronologie des sorties d'un produit, vérifiez si le modèle distingue les annonces préliminaires des lancements effectifs, s'il confond les dates selon les régions ou les plateformes et s'il fournit une source traçable pour chaque date importante.
Les tâches de programmation se prêtent à des critères similaires : la correction résout-elle le problème initial, passe-t-elle les tests existants et évite-t-elle de nouvelles régressions ? Ces résultats témoignent mieux de la qualité du raisonnement que la longueur ou le ton de la réponse.
2. Efficacité : combien de temps et d'argent demande une même tâche ?
L'efficacité se mesure sur l'ensemble du processus, de la demande initiale au résultat utilisable. Une première réponse rapide peut malgré tout allonger la durée totale si elle exige des précisions répétées, des corrections ou de nouvelles exécutions.
Si Grok 4.7 devient disponible via une API, les mesures suivantes seraient utiles dans des conditions comparables :
- La durée totale de la tâche et l'attente avant le début de la réponse.
- La consommation totale de tokens, le nombre d'appels d'outils et de nouvelles tentatives.
- Le coût par tâche réussie, calculé selon les règles de facturation applicables.
Une réponse plus courte n'est pas nécessairement plus efficace. Si elle omet des éléments de preuve indispensables, sa vérification et sa reprise prennent encore du temps. L'amélioration idéale préserverait la qualité du résultat tout en réduisant les attentes et les efforts répétés.
3. Tâches d'agents : l'exécution est-elle fiable jusqu'au résultat final ?
Dans un processus utilisant un agent, le modèle doit choisir des outils, lire leurs résultats et décider des étapes suivantes à mesure que de nouvelles informations arrivent. Une erreur à n'importe quelle étape peut affecter le livrable final. La fiabilité des appels d'outils et la capacité à se reprendre après un échec sont donc essentielles à l'évaluation.
Pour une tâche consistant à réunir des sources et rédiger un rapport comparatif, vérifiez si le modèle :
- Choisit des sources adaptées et conserve des références vérifiables.
- Transmet les bons arguments aux outils de recherche, de lecture de fichiers et d'analyse.
- Adapte son approche après un lien indisponible ou une erreur d'outil, au lieu de répéter l'échec.
- Respecte les exigences initiales pendant toute une tâche longue.
- Indique clairement ce qui est terminé et ce qui nécessite encore une intervention humaine.
Le nombre d'interventions humaines est un indicateur utile. Si l'utilisateur doit constamment rappeler l'objectif, corriger les arguments des outils ou combler des omissions, l'automatisation fait gagner moins de temps. Le modèle, les autorisations des outils et l'environnement d'exécution influencent tous le résultat : documentez-les séparément pour ne pas attribuer à la capacité du modèle toutes les différences liées au produit.
Que faut-il comparer avec Grok 4.6 ?
Pour l'instant, il est utile de définir une référence, puis d'ajouter les résultats lorsque la documentation officielle et l'accès à Grok 4.7 seront disponibles. Le tableau suivant compare les informations vérifiables pour cet article ; il ne s'agit pas d'un classement des performances.
| Point de comparaison | Grok 4.6 | Grok 4.7 |
|---|---|---|
| Preuve de lancement | Entrée officielle : API disponible le 12 août 2026 | Aucune entrée officielle de sortie trouvée lors de cette vérification |
| Documentation des capacités | Documentation officielle disponible | Informations vérifiées insuffisantes ici pour confirmer les améliorations |
| Calendrier | Lancement documenté | Le 12 septembre est une estimation conditionnelle issue d'une information non vérifiée |
| Comparaison des performances | Peut servir de référence sur les tâches existantes | À tester dans les mêmes conditions une fois disponible |
La date de sortie de Grok 4.6 provient des notes de version officielles ; ses capacités documentées figurent sur la page officielle du modèle.
Si vous utilisez déjà Grok 4.6, conservez les entrées, les sorties et les durées de quelques tâches courantes. Vous disposerez ainsi d'une référence concrète à l'arrivée de la nouvelle version, plutôt que d'un souvenir imprécis des performances précédentes.
Notez aussi l'interface, les réglages de raisonnement, les autorisations des outils et la date du test. Le chat Web et l'API, ou une recherche activée et désactivée, peuvent donner des résultats différents. Documenter ces conditions facilite leur interprétation.
Comment tester les progrès sur des tâches réelles après le lancement ?
Les benchmarks montrent comment un modèle traite certains types de questions, mais son utilité dans votre travail doit encore être vérifiée en pratique. Préparez quelques tâches assorties de critères d'acceptation clairs, comme la vérification de faits, la correction de code et l'analyse de documents.
Voici un exemple de protocole facile à examiner :
- Conserver la même tâche et les mêmes sources. Donnez aux deux modèles la même question, les mêmes fichiers et les mêmes exigences de sortie. Si une recherche Web est nécessaire, notez les sources et les heures de consultation.
- Définir la réussite avant les tests. Précisez les questions auxquelles le rapport doit répondre, les preuves nécessaires aux conclusions ou les tests que le code doit réussir.
- Documenter toute l'exécution. Relevez la durée totale, les tentatives supplémentaires, les appels d'outils et les précisions ou corrections de l'utilisateur. Pour l'API, ajoutez la consommation de tokens et le coût.
- Vérifier chaque exigence. Assurez-vous que les références étayent les conclusions, que les informations importantes sont présentes, que le code fonctionne et que les analyses documentaires ou les calculs sont exacts.
- Répéter les tests et comparer les résultats. Utilisez plusieurs exécutions pour évaluer la régularité, plutôt qu'une réponse exceptionnellement bonne ou mauvaise.
Les résultats doivent répondre à des questions concrètes : la précision progresse-t-elle ? Les omissions sont-elles moins nombreuses ? Faut-il moins de corrections manuelles ? Une qualité équivalente est-elle obtenue plus vite ou à moindre coût ? Ces réponses sont plus utiles pour décider d'un changement de modèle qu'une affirmation générale sur son intelligence.
Pour conclure
L'intérêt de Grok 4.7 dépendra de sa capacité à transformer des progrès potentiels en recherches plus fiables, en utilisation plus stable des outils et en livrables demandant moins de reprises. La date exacte de sortie et l'ampleur des améliorations nécessitent encore davantage d'informations vérifiables.
En attendant les précisions officielles, documentez les performances de votre modèle actuel et préparez vos propres tests. Une fois la nouvelle version disponible, évaluez son intérêt selon la précision, l'exhaustivité, le temps et le coût.